 我的开源
Scrapy 介绍
Scrapy 是一个为了方便人们爬取网站数据,提取结构性数据而编写的分布式爬取框架。它可以应用在包括数据挖掘, 信息处理或存储历史数据等一系列的程序中。因其功能颇多,所以学会它需要一定的时间成本。
特点
- HTML, XML 源数据 选择及提取 的内置支持
- 提供了一系列在 spider 之间共享的可复用的过滤器(即 Item Loaders),对智能处理爬取数据提供了内置支持。
- 通过 feed 导出 提供了多格式(JSON、CSV、XML),多存储后端(FTP、S3、本地文件系统)的内置支持
- 提供了 media pipeline,可以 自动下载 爬取到的数据中的图片(或者其他资源)。
- 高扩展性。您可以通过使用 signals ,设计好的 API(中间件, extensions, pipelines)来定制实现您的功能。
- 内置的中间件及扩展为下列功能提供了支持:
- cookies and session 处理
- HTTP 压缩
- HTTP 认证
- HTTP 缓存
- user-agent 模拟
- robots.txt
- 爬取深度限制
- 健壮的编码支持和自动识别,用于处理外文、非标准和错误编码问题
- 针对多爬虫下性能评估、失败检测,提供了可扩展的 状态收集工具 。
- 内置 Web service, 使您可以监视及控制您的机器。
PIP 更换源
- 清华:https://pypi.tuna.tsinghua.edu.cn/simple
- 阿里云:https://mirrors.aliyun.com/pypi/simple/
- 中国科技大学 https://pypi.mirrors.ustc.edu.cn/simple/
- 华中理工大学:https://pypi.hustunique.com/
- 山东理工大学:https://pypi.sdutlinux.org/
- 豆瓣:https://pypi.douban.com/simple/
临时使用:在使用 pip 的时候加参数-i https://pypi.tuna.tsinghua.edu.cn/simple
CentOS 修改 ~/.pip/pip.conf (没有就创建一个), 修改 index-url 为国内镜像地址,内容如下:
[global]
timeout = 60000
index-url = https://pypi.tuna.tsinghua.edu.cn/simple
123
windows 下,直接在 user 目录中创建一个 pip 目录,如:C:\Users\xx\pip,新建文件 pip.ini,内容如下
[global]
timeout = 60000
index-url = https://pypi.tuna.tsinghua.edu.cn/simple
依赖
- lxml:XML 和 HTML 文本解析器,配合 Xpath 能提取网页中的内容信息。
- Twisted:Twisted 是 Python 下面一个非常重要的基于事件驱动的 IO 引擎。
- Microsoft Visual C++ : https://visualstudio.microsoft.com/downloads/
- pyOpenSSL:pyopenssl 是 Python 的 OpenSSL 接口。
-
pip install Scrapy
可以选择 https://pypi.org/下载离线包安装(Python 版本最好是稳定版的,不要最新的,最新的官网没有对应依赖包)
项目结构
scrapy startproject name
- scrapy.cfg:项目的配置文件,开发无需用到。
- scrapy_demo:项目中会有两个同名的文件夹。最外层表示 project,里面那个目录代表 module(项目的核心)。
- scrapy_demo/items.py:以字段形式定义后期需要处理的数据。
- scrapy_demo/pipelines.py:提取出来的 Item 对象返回的数据并进行存储。
- scrapy_demo/settings.py:项目的设置文件。可以对爬虫进行自定义设置,比如选择深度优先爬取还是广度优先爬取,设置对每个 IP 的爬虫数,设置每个域名的爬虫数,设置爬虫延时,设置代理等等。
- scrapy_demo/spider: 这个目录存放爬虫程序代码。
- init.py:python 包要求,对 scrapy 作用不大。
架构
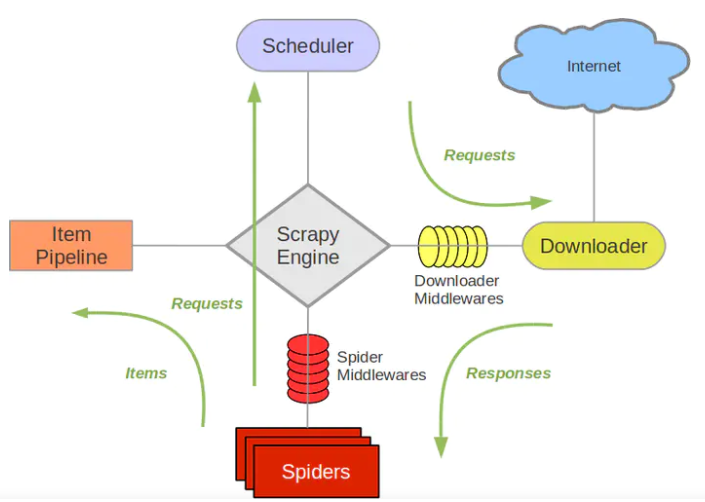
我按照从上而下,从左往右的顺序阐述各组件的作用。
- Scheduler :调度器。负责接受 Engine 发送过来的 Requests 请求,并将其队列化;
- Item Pipeline :Item Pipeline 负责处理被 spider 提取出来的 item。其有典型应用,如清理 HTML 数据、验证爬取的数据(检查 item 包含某些字段)、查重(并丢弃)、爬取数据持久化(存入数据库、写入文件等);
- Scrapy Engine :引擎是 Scrapy 的中枢。它负责控制数据流在系统中所有组件中流动,并在相应动作发生时触发事件;
- Downloader Middlewares :下载中间件是 Engine 和 Downloader 的枢纽。负责处理 Downloader 传递给 Engine 的 responses;它还支持自定义扩展。
- Downloader :负责下载 Engine 发送的所有 Requests 请求,并将其获取到的 responses 回传给 Scrapy Engine;
- Spider middlewares :Spider 中间件是 Engine 和 Spider 的连接桥梁;它支持自定义扩展来处理 Spider 的输入(responses) 以及输出 item 和 requests 给 Engine ;
- Spiders :负责解析 Responses 并提取 Item 字段需要的数据,再将需要跟进的 URL 提交给引擎,再次进入 Scheduler(调度器);
工作机制
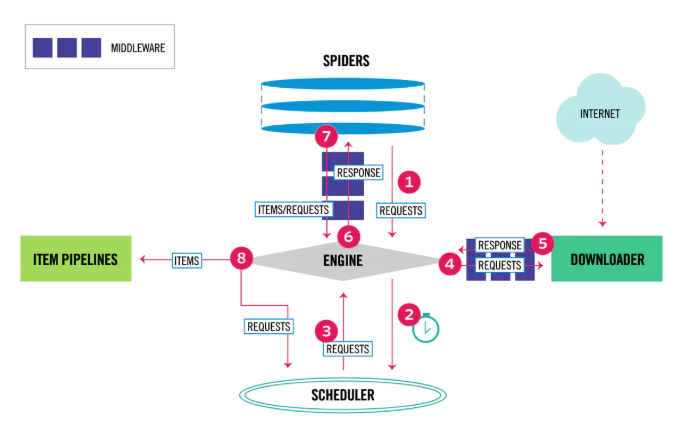
- 当引擎(Engine) 收到 Spider 发送过来的 url 主入口地址(其实是一个 Request 对象, 因为 Scrapy 内部是用到 Requests 请求库),Engine 会进行初始化操作。
- Engine 请求调度器(Scheduler),让 Scheduler 调度出下一个 url 给 Engine。
- Scheduler 返回下一个 url 给 Engine。
- Engine 将 url 通过下载中间件(请求(request)方向)转发给下载器(Downloader)。
- 一旦页面下载完毕,Downloader 生成一个该页面的 Response,并将其通过下载中间件(返回(response)方向)发送给 Engine
- 引擎将从下载器中接收到 Response 发送给 Spider 处理。
- Spider 处理 Response 并返回爬取到的 Item 及新的 Request 给引擎。
- Engine 将 Spider 返回的爬取到的 Item 转发给 Item Pipeline,顺便也将将 Request 给调度器。
- 重复(第 2 步)直到调度器中没有更多地 request,引擎关闭该网站。
Scrapy 使用
1 选取目标
网络爬虫,顾名思义是对某个网站或者系列网站,按照一定规则进行爬取信息。爬取程序的首要工作当然是选定爬取目标。本次爬取目标选择是 V电影,网址是 http://www.vmovier.com/。爬取内容是[最新推荐]栏目的前 15 条短视频数据信息。具体信息包括封面、标题、详细说明以及视频播放地址。
2 定义 Item
为什么将爬取信息定义清楚呢?因为接下来 Item 需要用到。在 Item.py 文件中,我们以类的形式以及 Field 对象来声明。其中 Field 对象其实是一个字典类型,用于保存爬取到的数据。而定义出来的字段,可以简单理解为数据库表中的字段,但是它没有数据类型。Item 则复制了标准的 dict API,存放以及读取跟字典没有差别。
3 编写 Spider
Spider 目录是我们爬虫程序爬取网站以及提取信息的模块。我们首先在目录下新建一个名为 VmoiveSpider 的文件。同时,该类继承 scrapy.Spider。
这里我们用到的 scrapy.spider.Spider 是 Scrapy 中最简单的内置 spider。继承 spider 的类需要定义父类中的属性以及实现重要的方法。
- name
这个属性是非常重要的,所以必须定义它。定义 name 目的是为爬虫程序命名。因此,还要保持 name 属性是唯一的。它是 String 类型,我们在 VmoiveSpider 可以定义:
name = 'vmoive'
- start_urls
start_urls 是 Url 列表,也是必须被定义。可以把它理解为存放爬虫程序的主入口 url 地址的容器。
- allowed_domains
可选字段。包含了 spider 允许爬取的域名(domain)列表(list)。 当 OffsiteMiddleware 启用时, 域名不在列表中的 URL 不会被跟进。根据 V 电影的 url 地址,我们可以这样定义:
allowed_domains = ['vmovier.com']
- parse(response)
parser 方法是 Scrapy 处理下载的 response 的默认方法。它同样必须被实现。parse 主要负责处理 response 并返回处理的数据以及跟进的 URL。该方法及其他的 Request 回调函数必须返回一个包含 Request 及(或) Item 的可迭代的对象。
4 运行程序
在项目目录下打开终端,并执行以下命令。我们没有 pipelines.py 中将爬取结果进行存储,所以我们使用 scrapy 提供的导出数据命令,将 15 条电影信息导出到名为 items.json 文件中。其中 vmoive 为刚才在 VmoiveSpider 中定义的 name 属性的值。
scrapy crawl vmoive -o items.json
5 进阶
上述代码只是在 V 电影主页中提取信息,而进入电影详情页面中匹配搜索信息。因此,我们是获取不到电影的播放地址的。如何搞定这难题?我们可以在 parse 方法中做文章。parse() 前文提到它必须返回一个 Reuqest 对象或者 Item。再者, Request 中就包含 url。换句话说,我们只有获取到电影详情页的 url 地址,并在传递给返回的 Request 对象中。
6 数据持久化
在实际生产中,我们很少把数据导出到 JSON 文件中。因为后期维护、数据查询、数据修改都是一件麻烦的事情。我们通常是将数据保存到数据库中。
我们先定义并创建数据库表,然后在 settings 文件中增加数据库的配置。最后我们要在 pipeline 文件中编写处理数据存储的代码。
开发小技巧
1 设置 User-agent
Scrapy 官方建议使用 User-Agent 池, 轮流选择其中一个常用浏览器的 User-Agent 来作为 User-Agent。scrapy 发起的 http 请求中 headers 部分中 User-Agent 字段的默认值是 Scrapy/VERSION (http://scrapy.org),我们需要修改该字段伪装成浏览器访问网站。
- 同样在 setting.py 中新建存储 User-Agent 列表,
UserAgent_List = [
    "Mozilla/5.0 (Windows NT 6.1) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/41.0.2228.0 Safari/537.36",
    "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_10_1) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/41.0.2227.1 Safari/537.36",
    "Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/41.0.2227.0 Safari/537.36",
    "Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/41.0.2227.0 Safari/537.36",
    "Mozilla/5.0 (Windows NT 6.3; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/41.0.2226.0 Safari/537.36",
    "Mozilla/5.0 (Windows NT 6.4; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/41.0.2225.0 Safari/537.36",
    "Mozilla/5.0 (Windows NT 6.3; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/41.0.2225.0 Safari/537.36",
    "Mozilla/5.0 (Windows NT 5.1) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/41.0.2224.3 Safari/537.36",
    "Mozilla/5.0 (Windows NT 10.0) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/40.0.2214.93 Safari/537.36",
    "Mozilla/5.0 (Windows NT 10.0) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/40.0.2214.93 Safari/537.36",
    "Mozilla/5.0 (Windows NT 6.3; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/37.0.2049.0 Safari/537.36",
    "Mozilla/5.0 (Windows NT 4.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/37.0.2049.0 Safari/537.36",
    "Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/36.0.1985.67 Safari/537.36",
    "Mozilla/5.0 (Windows NT 5.1) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/36.0.1985.67 Safari/537.36",
    "Mozilla/5.0 (X11; OpenBSD i386) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/36.0.1985.125 Safari/537.36",
    "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_9_2) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/36.0.1944.0 Safari/537.36",
    "Mozilla/5.0 (Windows NT 5.1) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/35.0.3319.102 Safari/537.36",
    "Mozilla/5.0 (Windows NT 5.1) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/35.0.2309.372 Safari/537.36",
    "Mozilla/5.0 (Windows NT 5.1) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/35.0.2117.157 Safari/537.36",
    "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_9_3) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/35.0.1916.47 Safari/537.36",
    "Mozilla/5.0 (Windows NT 5.1) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/34.0.1866.237 Safari/537.36",
    "Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/34.0.1847.137 Safari/4E423F",
    "Mozilla/5.0 (Windows NT 6.1; WOW64; rv:40.0) Gecko/20100101 Firefox/40.1",
    "Mozilla/5.0 (Windows NT 6.3; rv:36.0) Gecko/20100101 Firefox/36.0",
    "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_10; rv:33.0) Gecko/20100101 Firefox/33.0",
    "Mozilla/5.0 (X11; Linux i586; rv:31.0) Gecko/20100101 Firefox/31.0",
    "Mozilla/5.0 (Windows NT 6.1; WOW64; rv:31.0) Gecko/20130401 Firefox/31.0",
    "Mozilla/5.0 (Windows NT 5.1; rv:31.0) Gecko/20100101 Firefox/31.0",
    "Opera/9.80 (X11; Linux i686; Ubuntu/14.10) Presto/2.12.388 Version/12.16",
    "Opera/9.80 (Windows NT 6.0) Presto/2.12.388 Version/12.14",
    "Mozilla/5.0 (Windows NT 6.0; rv:2.0) Gecko/20100101 Firefox/4.0 Opera 12.14",
    "Mozilla/5.0 (compatible; MSIE 9.0; Windows NT 6.0) Opera 12.14",
    "Opera/9.80 (Windows NT 5.1; U; zh-sg) Presto/2.9.181 Version/12.00"
]
- 在 middlewares.py 文件中新建一个名为
RandomUserAgentMiddleware的代理中间层类
import random

from scrapy_demo.settings import UserAgent_List

class RandomUserAgentMiddleware(object):
    '''动态随机设置 User-agent'''
    def process_request(self, request, spider):

        ua = random.choice(UserAgent_List)
        if ua:
            request.headers.setdefault('User-Agent', ua)
            print(request.headers)
- 在 settings.py 中配置 RandomUserAgentMiddleware , 激活中间件
DOWNLOADER_MIDDLEWARES = {

    # 第二行的填写规则
    #  yourproject.middlewares(文件名).middleware类

    # 设置 User-Agent
    'scrapy.contrib.downloadermiddleware.useragent.UserAgentMiddleware': None,
    'scrapy_demo.middlewares.RandomUserAgentMiddleware': 400,  # scrapy_demo 是你项目的名称
}
2 禁用 cookies
有些站点会使用 cookies 来发现爬虫的轨迹。因此,我们最好禁用 cookies
在 settings.py 文件中新增以下配置。
# 默认是被注释的, 也就是运行使用 cookies
# Disable cookies (enabled by default)
COOKIES_ENABLED = False
3 设置下载延迟
当 scrapy 的下载器在下载同一个网站下一个页面前需要等待的时间。我们设置下载延迟, 可以有效避免下载器获取到下载地址就立刻执行下载任务的情况发生。从而可以限制爬取速度, 减轻服务器压力。
在 settings.py 文件中新增以下配置。
# 默认是被注释的
# Configure a delay for requests for the same website (default: 0)
# See http://scrapy.readthedocs.org/en/latest/topics/settings.html#download-delay
# See also autothrottle settings and docs
DOWNLOAD_DELAY = 3
# 单位是秒,  上述设置是延迟 3s。
# 同时还支持设置小数, 例 0.3, 延迟 300 ms
4 设置代理
有些网站设置反爬虫机制,这使得我们的爬虫程序可能爬到一定数量网页就爬取不下去了。我们需要装饰下爬虫,让它访问网站行为更像类人行为。使用 IP 代理池能突破大部分网站的限制。
- 我们可以通过国内一些知名代理网站(例如:迅代理、西刺代理)获取代理服务器地址。
我将自己收集一些代理地址以列表形式保存到 settings.py 文件中
# 代理地址具有一定的使用期限, 不保证以下地址都可用。
PROXY_LIST = [
    "https://175.9.77.240:80",
    "http://61.135.217.7:80",
    "http://113.77.101.113:3128"
    "http://121.12.42.180:61234",
    "http://58.246.59.59:8080",
    "http://27.40.144.98:808",
    "https://119.5.177.167:4386",
    "https://210.26.54.43:808",
]
- 在 middlewares.py 文件中新建一个名为
ProxyMiddleware的代理中间层类
import random

from scrapy_demo.settings import PROXY_LIST

class ProxyMiddleware(object):
    # overwrite process request
    def process_request(self, request, spider):
        # Set the location of the proxy
        # request.meta['proxy'] = "https://175.9.77.240:80"
        request.meta['proxy'] = random.choice(PROXY_LIST)
- 在 settings.py 文件中增加代理配置:
DOWNLOADER_MIDDLEWARES = {

    # 第二行的填写规则
    #  yourproject.middlewares(文件名).middleware类

    # 设置代理
    'scrapy.contrib.downloadermiddleware.httpproxy.HttpProxyMiddleware': 110,
    'scrapy_demo.middlewares.ProxyMiddleware': 100,  # scrapy_demo 是你项目的名称
}
除此之外,如果你比较狠的话,可以采用 VPN + Tor 方式来突破反爬虫机制。
5 减小下载超时
如果您对一个非常慢的连接进行爬取(一般对通用爬虫来说并不重要), 减小下载超时能让卡住的连接能被快速的放弃并解放处理其他站点的能力。
在 settings.py 文件中增加配置:
DOWNLOAD_TIMEOUT = 15
6 页面跟随规则
在爬取网站时,可能一些页面是我们不想爬取的。如果使用 最基本的 Spider,它还是会将这些页面爬取下来。因此,我们需要使用更加强大的爬取类 CrawlSpider。
我们的爬取类继承 CrawlSpider,必须新增定义一个 rules 属性。rules 是一个包含至少一个 Rule(爬取规则)对象的 list。 每个 Rule 对爬取网站的动作定义了特定表现。CrawlSpider 也是继承 Spider 类,所以具有 Spider 的所有函数。
Rule 对象的构造方法如下:
Rule(link_extractor, callback=None, cb_kwargs=None, follow=None, process_links=None, process_request=None)
我们在使用 Rule 一般只会用到前面几个参数,它们作用如下:
- link_extractor: 它是一个 Link Extractor 对象。 其定义了如何从爬取到的页面提取链接。
link_extractor 既可以自己定义,也可以使用已有 LinkExtractor 类,主要参数为:- allow :满足括号中“正则表达式”的值会被提取,如果为空,则全部匹配。
- deny :与这个正则表达式(或正则表达式列表)不匹配的 Url 一定不提取。
- allow_domains :会被提取的链接的 domains。
- deny_domains :一定不会被提取链接的 domains。
- restrict_xpaths :使用 xpath 表达式,和 allow 共同作用过滤链接。还有一个类似的
restrict_css
- callback :从 link_extractor 中每获取到链接时将会调用该函数。它指定一个回调方法。会返回一个包含 Item 对象的列表。
- follow :它 是一个布尔(boolean)值,指定了根据该规则从 response 提取的链接是否需要跟进。 如果 callback 为 None, follow 默认设置为 True ,否则默认为 False 。
- process_links :从 link_extractor 中获取到链接列表时将会调用该函数。它同样需要指定一个方法,该方法主要用来过滤 Url。
标题:Scrapy爬虫框架初探
作者:General
地址:https://ZZUGEneral.github.io/articles/2020/10/21/1603287789767.html
一个没有得到Java开发工作的测试员!